大企業向け業務デジタル化クラウド「SmartDB」は、ノーコードの業務アプリで日々の申請・承認を回すだけで、意味・文脈・権限を備えた「AI Readyデータ」を蓄積する。AI機能「SmartDB Practical AI」や今後の進化構想をQ&Aで解説する。
SmartDBの基本と特徴
SmartDBは、大企業の複雑かつ大規模な業務をデジタル化する基盤で、Webデータベース、柔軟なワークフロー、複雑な権限制御を一体で備えている点が特徴だ。情報システム部門だけでなく事業部門も完全ノーコードで業務アプリを作成でき、申請、承認、受発注といったプロセスを現場主導で構築・改善できる。
取締役 常務執行役員 CTO/サービス&プロダクト開発本部 本部長の藤田裕之氏は、SmartDBが単にデータをためる場所ではなく、申請・承認・判断といった日々の業務そのものを動かす基盤である点を強調する。業務や組織が複雑で現場の独自性が強い日本の大企業では、全社データを一カ所に集めてトップダウンでAI基盤を整えるよりも、日々の業務からデータとその意味を積み上げる方が現実的だとされる。現場が自ら業務アプリを作り、改善を重ねる「内製化」を支える基盤として、SmartDBはその役割を担っている。
SmartDBが「AI Readyデータ」を生む仕組み
申請・承認・コメントといった日々の業務を重ねることで、「誰が、どのような判断をしたのか」「どの文書が関連しているのか」が文脈を伴ってつながる。藤田氏によれば、LLM(大規模言語モデル)は世の中の一般的な知識は持っていても、個々の会社のことを知らない。予算額や稟議の承認結果といった確定情報はERPやCRMなどのSoR(System of Record)に残るが、そこに至る議論や差し戻しコメント、意思決定の根拠といった文脈は散逸しがちだ。
SmartDBでは、現場の担当者がアプリを作って申請・承認を回し、コメントを残すという日々の業務そのものが、文脈を伴うデータの蓄積につながる。こうしてできる構造は「Context Graph(コンテキストグラフ)」と呼ばれ、データの意味や相互の関係性を整理した知識の設計図である「オントロジー」の形成にもつながる。藤田氏は、データをわざわざ集めて分析しなくても、現場でアプリを使っているだけでAI Readyデータが副産物として自然とたまり、それが宝の山になると述べている。
DreamArtsは、業務アプリケーションが生み出すデータを「Data as a Product」として整え、アプリケーションや部門を越えてつながる「データメッシュ」の世界観を目指しており、SmartDBはその構成要素の一つだ。データレイクも構成要素として生かしながら、データの意味や業務との関係性を保つ点が、中核集約型のアプローチとの違いだとされる。
データガバナンスと複雑なアクセス権限の管理
複数部門の兼務や頻繁な組織改編がある大企業では、アクセス統制が課題になる。SmartDBでは、権限もデータの一部として管理されている。SmartDBを通じて質の高いデータを蓄積できるだけでなく、ガバナンスを確保した安全なAI活用も実現できる。
権限をデータの一部として持っているため、異動や昇格にもリアルタイムに追従し、利用者の権限に合わせてAIが提示する情報を制限できる。大企業のアクセス統制は複雑で、複数部門の兼務、プロジェクト単位で異なる権限、さらに組織改編や人事異動などが重なり、誰がどのデータを見てよいのかを正しく管理し続けるのは容易ではない。AIが社内データを参照するようになれば、この権限管理はそのままAI活用の安全性に直結する。
SmartDBは、権限をデータと切り離さず、データの一部として保持している。そのため、異動や昇格といった変化にもリアルタイムに追従し、利用者の最新の権限に応じてAIが提示する情報を制限できる。藤田氏は、この点がガバナンスにおいて大きな差になると述べている。意味と文脈をひも付けるContext Graphやオントロジーに加え、データと一体となった権限を日々の業務の中で育てることが、DreamArtsが掲げる「意味のDX」の実体だ。
SmartDB Practical AIでできること
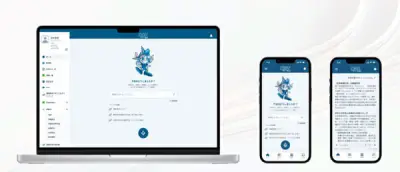
2026年4月に実装された「SmartDB Practical AI」が重視するのは、AIを業務プロセスそのものに組み込み、組織として継続的に活用することだ。業務ごとに設計したプロンプトは「プロンプトデータベース」で一元管理され、あらかじめ業務プロセスに組み込まれる。ユーザー自身がプロンプトを入力する必要はないため、個人のAIスキルに依存せず、日々の業務の中で自然にAIを使える仕組みになっている。内製化の対象が、業務アプリの構築からAI活用へと広がり始めているといえる。
藤田氏が紹介した事例では、ある企業で稟議を上げる際、Excelの膨大な規定集から分類コードを入力する手順が原因で、入力ミスによる差し戻しが6割に達していた。AIオプションを組み込んだことで、規定集を学習したAIが適切なコードをサジェストするようになり、意思決定の遅れを解消できたという。会社独自のルールや暗黙知を業務プロセスに組み込み、申請時のチェックをAIが支援することで、利用者は意識しないままAIの恩恵を受けられる。
SmartDBの今後の進化と「業務コンテキストサーバ」構想
2026年後半から2027年にかけて「意味のDX」を段階的に実装し、意思決定を支える基盤へと進化させる計画だ。2026年に入り、AIエージェントは質問に答える存在から「実務を代行してくれる存在」へと変わりつつある。こうした流れを受け、SmartDBは業務の文脈を踏まえてAIが意思決定を支援する基盤を目指している。
例えば、引き継ぎ先を引き継いだ営業担当者がAIエージェントに「過去の経緯を知りたい」と入力すると、AIは商談履歴や関連文書、これまでの判断を踏まえて要点を整理し、次のアクションまで提案する。上司の承認時にも、過去の経緯や権限に応じて必要な情報が提示される。
さらに将来的には、MCP(Model Context Protocol)を通じて外部のAIエージェントに業務データを安全に提供する「業務コンテキストサーバ」としての利用も構想されている。その要となるのが、どのエージェントにどこまでアクセスを許すかを管理する「AIエージェント基盤」だ。藤田氏は、参照できるデータや実行できる操作まで十分に制限できなければ事故につながりかねないため、エージェントごとに権限を設定して適切に管理する必要があると述べている。権限をデータの一部として扱ってきたSmartDBの特性が、ここでも生かされることになる。
まとめ:AI時代こそ「DX内製化」を推進する
藤田氏は、AIで成果を挙げるにはまず業務をデジタル化する必要があると言う。Excelやメールを使う定型業務をシステム化して、業務の文脈を蓄積する。「急がば回れ」の姿勢が欠かせない。
日本ではデジタル人材の約7割がITベンダー側にいるとされ、IT活用を外部に委ねてきた。だからこそ、自社の業務を知る人が自らデジタル化し、その知識や文脈を社内に蓄積することが重要だ。藤田氏は、AIの専門家がいなくても、現場がSmartDBでアプリを作り日々の業務を回す積み重ねが、他社には模倣できない「AI Readyデータ」を自然に育てると述べている。数年かかるデータ統合を待つ必要はない。目の前の業務を一つずつSmartDBでデジタル化していくことが、AI時代の競争力につながる。