Clouderaは2026年8月、シンガポールで開催した年次カンファレンス「EVOLVE26」において、従来のApache Hadoop基盤とは異なる新たなハイブリッドデータ/AIプラットフォーム「Cloudera Anywhere Cloud」を発表した。CDPと補完・共存する位置付けの製品だ。
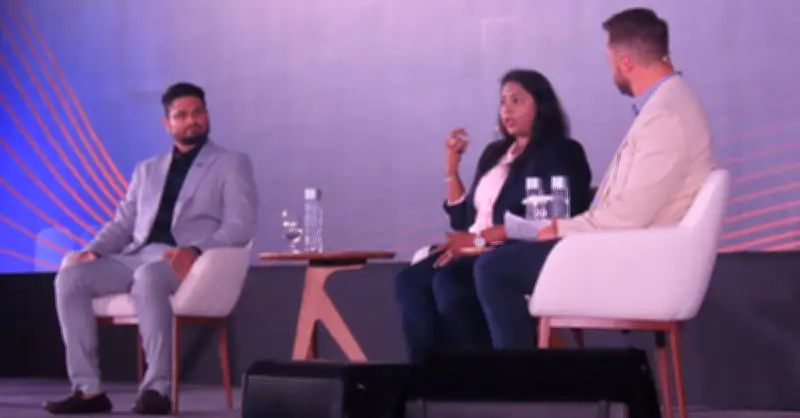
同カンファレンスでは、Anywhere Cloudのデザインパートナーとして先行導入を進める米ExxonMobilと、CDPをベースに独自のAI基盤を構築した米AbbVieの担当者が、それぞれ活用事例を語った。
ExxonMobil、データ所在地にコンピュートを置く判断
石油大手のExxonMobilが扱うデータの大半は、センサーやガスメーター、アナライザーなどから生成される非テキストの産業データ・オペレーショナルデータだ。AI活用のためにクラウドに移行する手段もあるが、同社エンタープライズアーキテクトのアンヴェシュ・コリペラ氏によれば、こうしたデータの多くはオンプレミスの産業システムに蓄積されている。クラウドへの移行に当たっては、データグラビティやコスト、各国の規制対応という制約が課題になっていた。
もう一つの課題はデータ統合基盤の分散だ。データエンジニアリングやデータウェアハウス、AIといった機能をばらばらに配置するのではなく、コンピュートとデータを切り離して「どこからでもアクセスできる単一の環境」を構築できるか模索していた。
こうした制約などを考慮し、ExxonMobilが最終的に選んだのはハイブリッドクラウドだった。コリペラ氏は「データがある場所にコンピュートを置く方が理にかなっている」と当時の判断を振り返る。システムアーキテクトのモニカ・トゥラシ氏も、全データをクラウドへ移す選択肢は取らず、「事業を成り立たせる上で意味のある場所にコンピュートを配置する方針にした」と補足する。
Anywhere Cloudで実現したフィジカルAIとコスト最適化
そこで導入したのがClouderaのAnywhere Cloudだ。Anywhere Cloudは本イベントで正式発表されたが、ExxonMobilは設計段階から関わるデザインパートナーとして数カ月前に導入を進めており、コリペラ氏は自身を「(実験台を意味する)モルモット」と表現した。
当初の試験導入では手作業のステップが多く残っていたが、直近のインストールではクリック一つでクラスタ展開からデータエンジニアリング・データウェアハウジングなど4つの機能が稼働するまでを自動化できたという。所要時間は、数カ月前の初回導入で約6時間かかっていたのに対し、直近は65分に短縮されたと明かした。
同社がAnywhere Cloudによって実現しているのが、フィジカルAIのユースケースだ。世界各地の製油所やプラントから常時得られる画像データを解析し、安全上の問題や設備保守の予兆を検知する。このような画像解析は絶え間なく行われるためコンピュート負荷が高く、クラウドの従量課金(トークン課金)のまま実行するとコストが膨らみやすい。そこで、Anywhere Cloudが備えるオンプレミス推論機能を活用し、コストの最適化を図った。
「オンプレミスのGPUインフラとクラウドのコンピュートを併用することで、コストをコントロールしたい」とコリペラ氏。また、GPUの調達自体がクラウド、オンプレミスいずれの環境でも容易ではない現状に触れた上で、同じコードをクラウドとオンプレミスのどちらにもデプロイできる可搬性を評価した。GPUが確保できた環境に処理を移せること自体が、コスト効率の高い運用につながるという。
AIエージェントの活用も視野に入れている。トゥラシ氏は「従来型AIからエージェント型AIへの移行期にある」と位置付ける。トゥラシ氏が目指す基盤の姿は、エッジデバイス側でデータを取り込み、ISVパートナーとも連絡しながら構造化データ・半構造化データ・非構造化データを横断的に扱う一元化されたレイクハウス基盤を中核に据えるというものだ。その上でストリーミング分析の仕組みを整え、将来的にはエージェント型AIへとつなげていく構想を描いているという。バッチ処理中心のデータ活用から、リアルタイム性の高いストリーミング処理へ移行することが、この構想の前提になるとトゥラシ氏は話す。
今後の展望としてトゥラシ氏は、エッジデバイスからAI基盤までを一つの統合プラットフォームとして扱う構想を語った。具体的には、プラント設備の画像データを使った異常検知や、問題の根本原因分析への活用を挙げ、こうした仕組みによってエンジニアが日々の高付加価値業務に集中できる環境を目指すとした。エッジ側のデータ収集には、「Apache MiniFi」などの技術も活用しているという。
AbbVie、独自基盤で70〜80%の時間短縮と無制限アクセスとガバナンスの両立
AbbVieは時価総額が約5000億ドル規模の医療・ヘルスケア大手だ。
同社で最高AIプロダクトオーナーとしてR&D領域のAI活用を統括するブライアン・マーティン氏は、この業界の特徴として、創薬から臨床試験、規制当局への承認申請に至るまで、専門家の経験や知見に基づく定性的な判断が意思決定の中心を占めると説明する。こうした領域にAIを導入するに当たって、AbbVieは効果を測る独自のフレームワークを使っている。マーティン氏によると、価値を「オペレーショナル」(効率化)、「アナリティカル」(予測精度)、「エクスペリエンシャル」(体感)に分類し、投資判断の基準としているという。
アナリティカルな価値の一例として、臨床報告書や論文などの非構造化データからナレッジグラフを構築し、専門家の定性的な判断に定量的な指標を組み合わせる取り組みを進めてきた。「この分子は患者に対して成功する確率が高い」といった数値的根拠を、医師や科学者の判断に上乗せできるようになったとマーティン氏は説明する。
オペレーショナルな価値の一例としては、規制当局への申請文書の作成を挙げた。米食品医薬品局(FDA)への申請には最大2000件の文書が必要になり、そのうちの一つである臨床試験報告書は300〜400ページに及び、初回作成だけで数週間を要していたという。AbbVieは年間約100件の臨床試験を実施しており、ナレッジグラフを活用した文書構造の整理と生成AIによる初回作成を組み合わせることで、「70〜80%の時間短縮」を実現したとマーティン氏は明かした。
これらの取り組みを可能にしているのが、「AbbVie R&D Convergence Hub」(ARCH)だ。約4〜5年前、社内外の270のデータソースを統合し、データそのものではなく「知識」をナレッジグラフとして扱う基盤として独自構築した。マーティン氏は、それまで「Kubernetes」クラスタでグラフデータベースを動かすために手作業で環境を構築していたと振り返り、「(Anywhere Cloudのような仕組みが)4〜5年早くあればよかった」と述べた。グラフデータベースの連携先としては「Neo4j」の名前も挙がった。
パートナー企業をどう組み込むかについて、マーティン氏は「AIはチームスポーツだ」と表現する。特定のスタートアップや実績のある企業を状況に応じて組み合わせる姿勢を強調する一方で、AI導入プロジェクトが失敗に終わる大きな要因として「技術主導」で進めてしまう点を指摘した。「解決すべきビジネス課題を先に定義し、そこに必要な技術を当てはめていく」という順序の重要性を説く。
こうした体制作りの一环として、マーティン氏が強調したのが事業部門の現場に配置される技術者である「Forward Deployed Engineer」(FDE)の存在だ。FDEが「技術者と科学者の間に本来存在する信頼関係のギャップを埋める役割を担っている」とマーティン氏。そして、AI活用における最大の課題は「技術そのものよりも、組織文化や人と人との関係構築にある」とも述べた。
取り組みの成果は出ているようだ。自社開発の生成AIツールについて2024年の利用実績を分析したところ、全体利用の3分の1に満たない範囲でも、フルタイム従業員換算で「25万時間」相当の時間創出効果があったとマーティン氏は明かした。この時間は従業員の業務が不要になったことを意味するのではなく、「より付加価値の高い業務に充てる時間として確保された」という。
こうした成果が得られた背景として、同社が全従業員にLLMへの無制限アクセスを与えた経緯があるという。「実践できなければ、投資対効果を測ることはできない」とマーティン氏はその狙いを説明する。だが現場の利用量が経営側の想定を上回ったため、対応が必要になったことも明かした。
急速な利用拡大を受け、統制(ガバナンス)の仕組み作りも進めてきた。同社では、AIエージェントの判断に人間が関与する「human in the loop」(ヒューマン・イン・ザ・ループ)の仕組みを3段階に分類したとマーティン氏は話す。最も厳格な形が、AIの出力を人間が確認し、ボタンを押して次の処理に移す「エアギャップ型」。それ以外に、閾(しきい)値を自動的に監視する形、結果を事後的に確認する形があるという。
ガバナンスを技術面で支えるべく、同社は約2年半前から、全社のLLMトラフィックを一元化して可視化する「LLMゲートウェイ」を運用している。新しいモデルが公開されると24〜48時間以内に社内インフラへ追加し、開発者がすぐに試せるようにしている。同時にLLMゲートウェイを経由した通信を必須とすることで、利便性とガバナンスを両立させる仕組みだ。同LLMゲートウェイから得られた従業員と生成AIとの会話、約59万件を2年間にわたって分析した論文も公開しており、教育施策や機能リリースの効果を定量的に測定していると述べた。
各社がAI投資を進める一方で、投資対効果にも厳しい目が向けられるようになった。TCO(総所有コスト)という観点についてマーティン氏は、「モデル単体の価格だけでなく全体のコスト構造を捉える必要がある」と強調した。「トークン単価が下落する一方、エージェント型ユースケースの増加によって利用量自体は増えている。単純な価格比較では実態を見誤る」と指摘する。
オンプレミスでの推論基盤を太陽光パネルによる自家発電になぞらえ、「クラウド一辺倒ではなく、自前で賄える分を確保しておくことがコストの土台を下げる」という考え方を紹介した。こうした発想の延長として、ソブリンAIやプライベートAIといった、オンプレミスとクラウド双方にモデルを配置する選択肢が今後の企業にとって重要になるという予想も示した。
最後にマーティン氏は「データそのものではなく、ナレッジを扱うナレッジグラフを軸としたプラットフォームが今後の主流になるだろう」との考えを示して対談を締めくくった。