今回は、リンク切れを検出するツールをPythonで自作する方法を紹介する。再帰の仕組みを理解していれば、思ったよりも簡単に作ることができ、Pythonでさまざまなツールを開発したい人にはぴったりの題材だ。ただし、作成時にはいくつかの注意点を押さえておく必要がある。
リンク切れチェッカーとは
Webサイト同士はリンクでつながっているが、リンク先の消滅やページ構造の変更などにより、リンク切れが発生することがある。リンク切れを放置すると、ユーザーの利便性が低下するだけでなく、検索エンジンの評価にも悪影響を及ぼす可能性がある。ページ数が多いサイトでは手動での確認が困難なため、リンク切れチェッカーが役立つ。
既存のツールを利用する方法もあるが、Webサイトの構造は複雑で、特定の条件でチェックしたい場合も多い。自作のチェッカーを使えば、効率よくリンク切れを検出できるだろう。ただし、何も考えずに作ると問題が生じるため、以下のポイントを確認しておこう。
作成時の5つの注意ポイント
リンク切れチェッカーを作成する際には、次の5つの点に注意する必要がある。
- サーバーへ大量アクセスを行うため、負荷対策が必須
- 指定したサイト以外は再帰チェックしない
- チェック済みのページを記憶しておく
- URLの正規化を行う
- 素材データはダウンロードせず、存在確認だけ行う
サンプルプログラムの使い方
サンプルプログラムは、Pythonの定番ライブラリ「requests」と「beautifulsoup4」を使用する。ターミナル(WindowsならPowerShell、macOSならターミナル.app)で次のコマンドを実行してインストールする。
pip install requests beautifulsoup4プログラムの実行は、次のコマンドで行う。
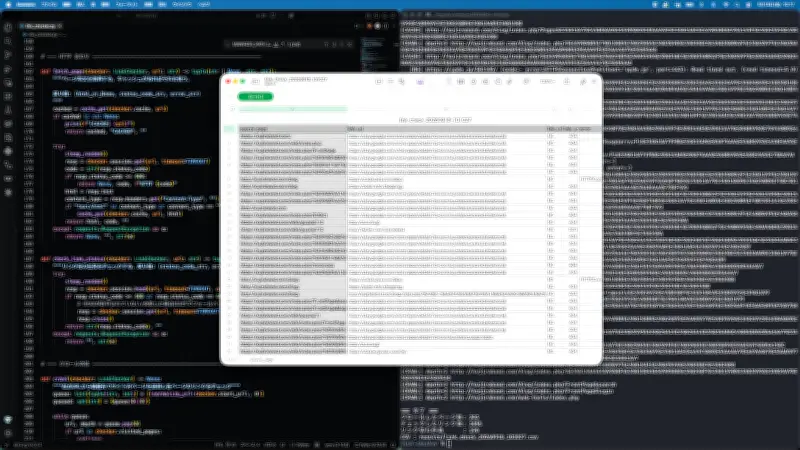
python link_checker.py https://example.com実行すると、以下のようなレポートが表示され、CSVファイルが作成される。
クロールしたページ数: 100チェックしたリンク数: 250リンク切れ件数 : 3CSV : results/link_check_20260918_112344.csvCSVファイルを表計算ソフトで開くと、リンクの検証結果を確認できる。
サーバー負荷対策の実装
リンクチェッカーは、Webサイトからリンクの一覧を抽出し、再帰的にリンクをたどるため、大量のWebアクセスを行う。短時間に大量のリクエストを送ると、WAFのレート制限に引っかかり、429や403が返される場合がある。最悪の場合、DoS攻撃と誤認される可能性もあるため、アクセス間隔を空けることが重要だ。
サンプルプログラムでは、sleep_random()関数を定義し、ファイルをダウンロードするタイミングで呼び出している。
WAIT_TIME = (1.0, 3.0) # リクエスト間の待機秒数の範囲(最小, 最大)def sleep_random() -> None:"""ランダムに待機し、サーバーへの負荷を抑える"""min_wait, max_wait = WAIT_TIMEtime.sleep(random.uniform(min_wait, max_wait))ページ取得関数では、最初に必ずsleep_random()を呼び出し、キャッシュ機能も備えている。
def fetch_page(checker: LinkChecker, url: str) -> tuple[str | None, str, str]:"""ページ本文を取得する。キャッシュがあればそれを使う"""cached = cache_get(checker.cache, url)if cached is not None:print(f"[CACHE] {url}")return cached, "CACHED", ""try:sleep_random() # ← 必ず待機してサーバー負荷を下げるresp = checker.session.get(url, timeout=TIMEOUT)code = str(resp.status_code)if resp.status_code >= 400:return None, code, f"HTTP {code}"html = resp.textcontent_type = resp.headers.get("Content-Type", "")if "text/html" in content_type or content_type == "":cache_put(checker.cache, url, html)return html, code, ""except requests.RequestException as e:return None, "", str(e)内部リンクのみを再帰チェック
リンクはサイト外にも存在するため、外部サイトを再帰的にチェックしないようにする必要がある。サンプルでは、is_internal()関数で内部リンクかどうかを判定し、内部リンクの場合のみキューに追加して再帰的にクロールする。
# HTMLをパースしてリンクを抽出し、チェックおよびキューへの追加を行うsoup = BeautifulSoup(html, "html.parser")for a_tag in soup.find_all("a", href=True):# …省略…link_url = normalize_url(urljoin(url, raw_href))# …省略…check_and_record(checker, link_url, source_page=url)if is_internal(checker, link_url) and depth + 1 <= checker.max_depth:if link_url not in checker.visited_pages and link_url not in queued:queue.append((link_url, depth + 1))# …省略…is_internal()関数は、以下のように定義されている。
def is_internal(checker: LinkChecker, url: str) -> bool:"""起点URLと同じドメインかどうかを判定する(サイト内リンクの再帰対象判定に使用)"""return urlparse(url).netloc == checker.base_domain訪問済みページの管理とURL正規化
ページAからB、BからAへの相互リンクや、A→B→C→Aのような循環リンクがあるため、一度チェックしたページを記憶し、再訪問を防ぐ必要がある。サンプルのcrawl()関数では、リスト型のqueueと集合型のvisited_pagesを使用して管理している。
def crawl(checker: LinkChecker) -> None:"""起点URLから幅優先でサイト内ページを巡回し各ページのリンクをチェック"""queue: list[tuple[str, int]] = [(normalize_url(checker.start_url), 0)]queued: set[str] = {queue[0][0]}while queue:url, depth = queue.pop(0)if url in checker.visited_pages:continuechecker.visited_pages.add(url)print(f"[CRAWL] depth={depth} {url}")# ...省略...URLには「#section1」のようなフラグメントが付く場合があり、フラグメントは同一ページ内の位置を示すため、リンクチェックでは同一ページとして扱う。Python標準ライブラリのurllib.parseのurldefragを使用する。また、相対パスはurljoin()関数で絶対URLに変換する。
from urllib.parse import urljoin, urldefragbase_url = "https://example.com/docs/page.html"url = urljoin(base_url, "../index.html#section1")print(url) # https://example.com/index.html#section1url, fragment = urldefrag(url)print(url) # https://example.com/index.htmlprint(fragment) # section1素材データは存在確認のみ
ZIPファイルや画像、音声ファイルなどの素材データは、実際にダウンロードせず存在確認だけ行うことで通信量を抑えられる。サンプルでは、URLの末尾の拡張子を確認するis_excluded()関数を使用している。
EXCLUDE_EXTENSIONS = (".pdf", ".jpg", ".jpeg", ".png", ".gif", ".zip", ".svg", ".ico", ".mp4", ".mp3")def is_excluded(url: str) -> bool:"""ダウンロード対象外かどうかを判定する"""path = urlparse(url).path.lower()return path.endswith(EXCLUDE_EXTENSIONS)また、他人が管理するサイトをクロールする場合は、サイトごとのルール「robots.txt」を確認し、利用条件を守る必要がある。
まとめと今後の拡張
リンク切れチェッカーは仕組みは単純だが、実用的なツールにするにはいくつかの注意点を考慮する必要がある。サンプルプログラムは基本的な機能を備えているため、特定のURLパターンを除外する機能などを追加して、自分のサイトチェック用にカスタマイズするとよいだろう。
なお、JavaScriptで動的にレンダリングされるページには対応していない。対応するには、Playwrightなどのライブラリでブラウザを直接操作する必要があるが、考え方は同じなので、改造してみるのもおすすめだ。